
SEO Local
GEO Local : la méthode pour se faire citer par ChatGPT, Perplexity et Gemini sur les requêtes locales
En bref
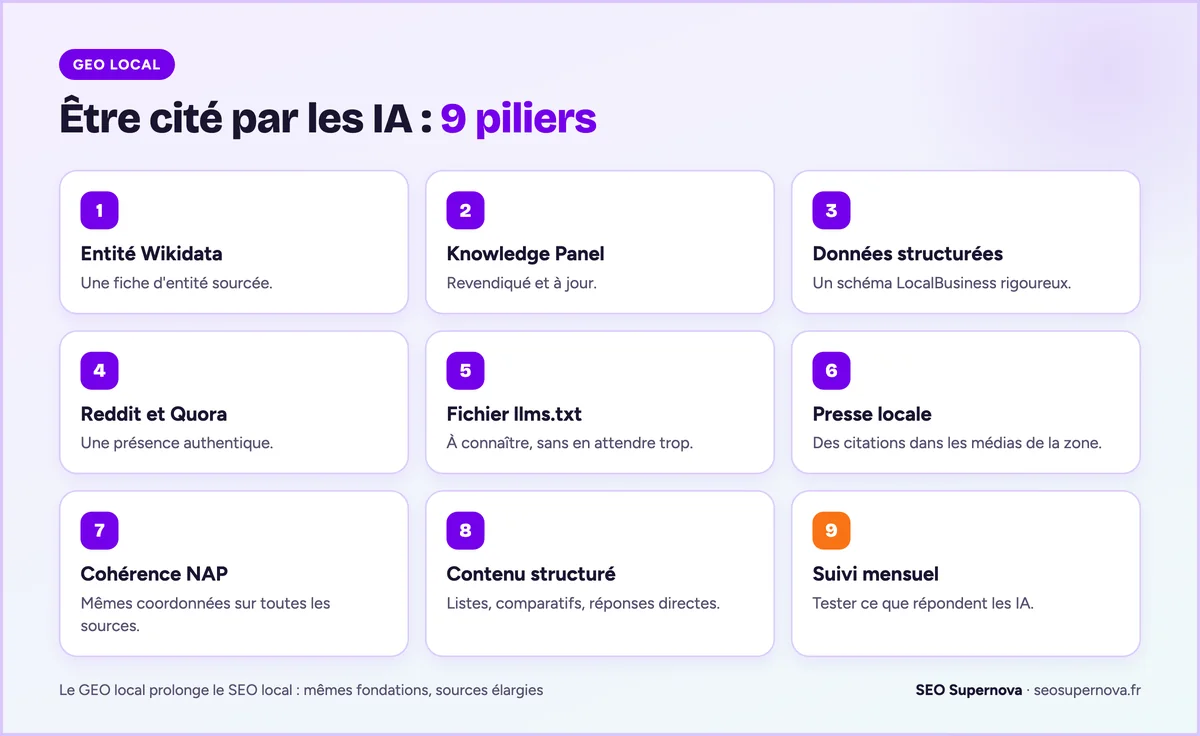
Le GEO (Generative Engine Optimization) optimise une présence pour qu'elle soit citée par les moteurs génératifs : ChatGPT, Perplexity, Claude, Gemini, Copilot, Mistral. Contrairement à l'idée reçue, le GEO n'est pas une discipline neuve : il recycle les signaux SEO classiques (Wikipedia, presse, sites d'autorité, schema.org, NAP cohérent, avis). La méthode GEO local en 9 piliers : entité Wikidata, Knowledge Panel Google validé, schema.org LocalBusiness profond, citations presse locale, Reddit/Quora ciblé, NAP ultra-cohérent, contenu listicle-friendly, llms.txt laissé de côté (la recherche Google ne l'utilise pas), monitoring multi-LLM. Les outils de monitoring GEO sont surtout payants (Peec.ai, AthenaHQ, Otterly.ai, Profound, Goodie.ai).
- 1Le GEO est largement du SEO renforcé : la plupart des signaux qui font ranker sur Google font aussi remonter dans les réponses LLM
- 2Reddit a signé en 2024 un contrat avec Google (environ 60 M$/an selon Reuters) et un partenariat avec OpenAI
- 3llms.txt : Google indique que sa recherche ne l'utilise pas (guide Google sur l'IA générative, mis à jour le 13/07/2026)
- 4Mesurer ses citations LLM passe par des outils surtout payants (Profound, AthenaHQ, Peec.ai, Otterly.ai, Goodie.ai) ou par du tracking manuel + logs serveur
Qu'est-ce que le GEO (Generative Engine Optimization) exactement ?
Le GEO - pour Generative Engine Optimization - est l'ensemble des techniques visant à faire apparaître une marque, une entreprise ou une page web dans les réponses générées par les moteurs IA : ChatGPT, Perplexity, Claude, Gemini, Copilot, Mistral, Le Chat, You.com.
Concrètement, c'est ce qui se joue quand un utilisateur tape, dans ChatGPT ou Perplexity :
- « quel est le meilleur ostéopathe à Lyon 6 »
- « plombier urgence Bordeaux dimanche »
- « avocat divorce Marseille recommandé »
- « pizzeria Naples Marais ouvert ce soir »
Le LLM ne génère pas une liste de 10 résultats bleus : il rend une réponse synthétisée, qui cite quelques sources. Le GEO détermine si vous êtes l'une de ces sources, ou pas. Pour une entreprise locale qui préfère confier ce travail, c'est le rôle de notre agence GEO.
GEO, AEO, LLMO : trois noms pour la même chose
Trois acronymes coexistent en 2026, désignant peu ou prou la même discipline :
- GEO (Generative Engine Optimization) - popularisé par une étude académique Princeton de 2023
- AEO (Answer Engine Optimization) - préféré dans la sphère anglo-saxonne SEO
- LLMO (LLM Optimization) - utilisé surtout dans la sphère tech
Nous utilisons GEO dans cet article.
Pourquoi le GEO est devenu un enjeu en 2026
Les chiffres ne mentent pas :
| Indicateur | Valeur | Source |
|---|---|---|
| Trafic ChatGPT (avril 2024 - mars 2025) | 47,7 Md visites (vs 28,5 Md l'année précédente, soit +67 %) | OneLittleWeb (données Semrush), 2025 |
| Croissance trafic Perplexity (avril 2024 - mars 2025) | 388 M → 1,3 Md visites (+243 %) | OneLittleWeb (données Semrush), 2025 |
| Deal Reddit ↔ Google (Gemini training) | 60 M$/an | Reuters / CBS News 2024 |
📚 Note méthodologique sur les chiffres
Les volumes de trafic ChatGPT et Perplexity viennent de l'étude OneLittleWeb « AI Chatbots vs Search Engines » (données Semrush, mise à jour d'avril 2025) : 47,7 milliards de visites ChatGPT entre avril 2024 et mars 2025, contre 28,5 milliards sur les douze mois précédents (+67 %), et Perplexity de 388 millions à 1,3 milliard de visites (+243 %) (source : OneLittleWeb (données Semrush), 2025).Pourquoi le GEO est du SEO renforcé (pas une discipline neuve)
C'est l'idée la plus mal comprise du marché : le GEO n'invente pas ses signaux, il recycle ceux du SEO classique. Google le dit lui-même : « optimiser la recherche par IA générative revient à optimiser l'expérience de recherche, et donc le SEO » (guide Google sur l'IA générative).
Les LLMs n'ont pas leur propre web
Les LLMs grand public s'appuient notamment sur :
- Common Crawl - corpus public qui revendique plus de 300 milliards de pages, ouvert depuis 2007 (commoncrawl.org)
- L'index Google ou Bing - quand ils font du web search en temps réel
- Wikipedia - pour les entités et faits vérifiables
- Schema.org - pour comprendre la nature d'une entité (entreprise, personne, produit)
- Knowledge Graphs - Google Knowledge Graph, Microsoft Knowledge Graph, Wikidata
Ces 5 sources sont précisément ce que le SEO travaille depuis 15 ans.
SEO ↔ GEO : le travail de référence
- L'étude académique fondatrice Aggarwal et al. (Princeton, 2023) : "GEO: Generative Engine Optimization", premier papier scientifique posant le cadre (arxiv.org/abs/2311.09735).
Implication opérationnelle : le GEO ne dispense pas du SEO, il s'y ajoute. Le SEO ouvre la porte ; c'est la cohérence de l'entité sur tout le web qui fait citer.
Voir la fondation à mettre en place côté SEO local.
Comment chaque LLM choisit-il ses sources ?
Chaque moteur génératif a sa propre cuisine. Comprendre ces différences permet d'orienter ses efforts vers les leviers qui paient sur chaque plateforme.
ChatGPT (OpenAI) : corpus + Bing temps réel + partenaires presse
ChatGPT utilise quatre couches de sources superposées :
Corpus d'entraînement statique, figé à la cutoff date du modèle. La composition exacte des modèles GPT-4 et GPT-4o n'est plus publiée par OpenAI depuis 2023 - la dernière documentation détaillée concerne GPT-2 (2019) avec WebText, et GPT-3 (2020) avec Common Crawl + WebText2 + Books1/2 + Wikipedia (Brown et al., 2020). Pour les générations suivantes, OpenAI parle simplement de « données publiques d'internet, données licenciées via partenariats, et données contribuées par les utilisateurs ». Le corpus est immuable entre deux versions de modèle.
Web browsing temps réel - ChatGPT Search (anciennement « browse with Bing ») interroge en arrière-plan un mélange de Bing et d'autres sources, récupère plusieurs résultats, les lit et synthétise. Conséquence : être bien référencé sur Bing reste critique pour la couche RAG de ChatGPT.
GPTBot crawler - le robot officiel d'OpenAI qui crawle le web pour enrichir les futurs corpus d'entraînement. User-agent :
GPTBot. Si vous bloquez GPTBot dansrobots.txt, votre contenu ne sera pas réintégré dans les prochaines versions du modèle.Partenariats presse signés - annoncés publiquement par OpenAI : Axel Springer (Bild, Welt), Associated Press, Financial Times, News Corp (WSJ, Times of London, NY Post), Le Monde, PRISA Media (El País), Vox Media (The Verge), The Atlantic, TIME, Condé Nast (Vogue, GQ, Wired, The New Yorker), Dotdash Meredith, Hearst (Cosmopolitan, Esquire), Future plc, Axios, Guardian Media Group, Washington Post.
Levier prioritaire pour le GEO local français côté ChatGPT : Bing Webmaster Tools + GPTBot autorisé + entité Wikipedia/Wikidata + mention dans la presse locale française.
Perplexity : recherche web en temps réel
Perplexity fonctionne en RAG (Retrieval-Augmented Generation) : il cherche sur le web au moment de la question, puis synthétise une réponse qui cite ses sources. Son robot d'indexation s'appelle PerplexityBot.
Gemini (Google) : Knowledge Graph + Reddit + YouTube
Gemini est intégré à l'écosystème Google. Sources :
- Google Knowledge Graph - agrégat propriétaire de Wikipedia, Wikidata, schema.org, sources officielles, fiches GBP validées
- Index Google standard en temps réel pour les requêtes nécessitant du recent
- Reddit - contrat Google-Reddit signé en 2024 (environ 60 millions $/an selon Reuters)
- YouTube - Google possède YouTube
Levier prioritaire côté Gemini : Knowledge Graph (revendiquer votre Knowledge Panel - voir notre guide complet du Knowledge Panel) + entité Wikidata + présence positive sur Reddit + chaîne YouTube si pertinent.
Claude (Anthropic) : corpus d'entraînement + web search
Claude utilise :
- Corpus d'entraînement - Anthropic ne publie pas la composition exacte de son corpus, mais documente publiquement l'utilisation de données web publiques, données licenciées via partenariats, et données utilisateurs opt-in. Composition exacte non détaillée par version.
- ClaudeBot - crawler officiel Anthropic, comportement et IPs documentés sur le site Anthropic Help Center. Respecte robots.txt.
- Web search - fonctionnalité déployée sur Claude.ai et l'API en 2025. Permet à Claude d'interroger le web en temps réel pendant la conversation.
Copilot (Microsoft) : GPT-4 + Bing + Microsoft Knowledge Graph
Copilot est essentiellement GPT-4 branché sur Bing, avec une couche Microsoft propre :
- Index Bing temps réel
- Corpus GPT-4 d'entraînement (similaire à ChatGPT)
- Microsoft Knowledge Graph (différent de Google Knowledge Graph)
Bing alimente Copilot + Edge + Windows 11 + Microsoft 365 + Outlook.
Levier prioritaire côté Copilot : Bing Webmaster Tools (inscription, sitemap, vérification - gratuit) + profil LinkedIn entreprise actif (LinkedIn appartient à Microsoft) + schema.org.
Mistral (Le Chat) : web search
Mistral est l'éditeur français de Le Chat. Il ne publie pas la composition détaillée de ses corpus d'entraînement ; Le Chat peut faire des recherches web pendant la conversation.
Levier prioritaire côté Mistral : contenu en français de qualité + entité Wikipédia FR + présence sur sources françaises (presse régionale, blogs métier français).
Récapitulatif : où concentrer ses efforts ?
| LLM | Source #1 à travailler | Source #2 | Source #3 |
|---|---|---|---|
| ChatGPT | Bing Webmaster + GPTBot autorisé | Wikipedia/Wikidata | Presse locale |
| Perplexity | SEO Top 10 Google | Schema.org | NAP cohérent |
| Gemini | Knowledge Panel revendiqué | Reddit/Quora | YouTube |
| Claude | Wikipedia (entité validée) | Médias établis | Schema.org rigoureux |
| Copilot | Bing Webmaster Tools | LinkedIn entreprise | Schema.org |
| Mistral / Le Chat | Wikipédia FR | Presse régionale FR | Contenu FR qualité |
La méthode GEO local en 9 piliers
Voici la séquence opérationnelle pour devenir une entité citée par les LLMs sur votre zone géographique.
Pilier 1 : Entité Wikidata (gratuit, 1h)
Wikidata est la base de données structurée alimentée par les wikipédiens.
Procédure :
1. Compte gratuit sur wikidata.org
2. Créer un nouvel item
3. Champs minimum : label (nom), description (1 ligne), instance of (organization, small business), country (France), headquarters location (ville), website, industry
4. Source obligatoire : une source secondaire (article de presse, mention officielle) OU votre fiche INSEE/Pappers
Pièges à éviter : auto-promotion explicite (suppression rapide), absence de sources (idem), création avant d'atteindre une notoriété mesurable.
Pilier 2 : Knowledge Panel Google revendiqué
Le Knowledge Panel est l'encadré à droite des résultats Google sur recherche de marque.
Procédure complète dans notre guide complet du Knowledge Panel Google.
Pilier 3 : Schema.org LocalBusiness ultra-rigoureux
À implémenter sur la page d'accueil + chaque page métier-ville :
{
  "@context": "https://schema.org",
  "@type": "Dentist",
  "name": "Cabinet Dr Martin",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "12 rue de la République",
    "addressLocality": "Lyon",
    "postalCode": "69002",
    "addressCountry": "FR"
  },
  "telephone": "+33478123456",
  "openingHoursSpecification": [...],
  "geo": {
    "@type": "GeoCoordinates",
    "latitude": 45.7640,
    "longitude": 4.8357
  },
  "priceRange": "€€",
  "aggregateRating": {...},
  "sameAs": [
    "https://www.facebook.com/...",
    "https://www.linkedin.com/...",
    "https://www.wikidata.org/wiki/Q..."
  ]
}
Le champ sameAs est particulièrement important : il fait le lien entre votre site et votre entité Wikidata / Knowledge Panel.
Notre générateur de schema markup produit ce code en 30 secondes à partir de vos données entreprise.
Pilier 4 : Présence Reddit et Quora authentique
En 2024, Reddit a signé un contrat avec Google (environ 60 M$/an selon Reuters) et un partenariat avec OpenAI.
La méthode propre, en 3 étapes : 1. Identifier les subreddits métier + géographiques pertinents (r/france, r/Lyon, r/Paris, r/medecinegenerale, r/btp, r/avocats, r/restaurateurs) 2. Créer 1 compte personnel (jamais marque), répondre à des questions sur votre expertise pendant 3-6 mois sans jamais parler de vous 3. Mentionner ponctuellement votre entreprise en réponse à une question pertinente
⚠ Reddit déteste l'astroturfing
Spammer Reddit avec des faux comptes pour mentionner sa marque est contre-productif : risque de bannissement. La seule méthode qui paie : participation authentique de long terme.Pilier 5 : Fichier llms.txt : inutile pour Google
Le fichier llms.txt est une proposition communautaire publiée en septembre 2024 par Jeremy Howard (Answer.AI). L'idée : un fichier markdown à la racine du site (https://votre-site.fr/llms.txt) listant les pages importantes avec leurs URLs et descriptions courtes, dans un format facile à parser pour un LLM.
⚠ Ce que dit Google
Dans son guide Google sur l'IA générative (mis à jour le 13/07/2026), Google indique qu'il est inutile de créer ces fichiers pour apparaître dans la recherche Google, y compris dans ses fonctionnalités d'IA générative, car la recherche Google « ne les utilise pas ». Ils n'ont aucune incidence sur la visibilité ou le classement d'un site dans Google.
Faut-il en créer un pour un site local français ?
Notre position : non. Consacrez ce temps au schema.org, à l'entité Wikidata et au NAP cohérent.
Pilier 6 : Citations presse locale (backlinks géo-locaux)
Stratégies réalistes : - Communiqué de presse à l'occasion d'un cap (anniversaire 5/10/20 ans, déménagement, nouvelle prestation) - Tribune métier dans la presse locale (« 5 conseils pour bien choisir son ostéopathe ») - Sponsoring d'événement local référencé presse (course, festival, conférence) - Participation à des dossiers thématiques sectoriels
Pour la méthode complète d'acquisition de backlinks locaux (presse, CCI, partenariats, achat propre sur plateformes éditoriales), voir notre guide complet des backlinks locaux.
Pilier 7 : NAP ultra-cohérent (multi-source)
À aligner strictement (même orthographe, même ponctuation, même ordre) :
- Google Business Profile, Bing Places, Apple Maps
- PagesJaunes, Yelp, Justacôté, Hoodspot
- Facebook, LinkedIn, Instagram
- Site web (page contact + schema.org + footer + mentions légales)
- INSEE / Pappers / Société.com
- 10-30 annuaires sectoriels selon métier (Doctolib pour la santé, TheFork pour la restauration, Bilik pour le BTP)
Pour la méthode détaillée : notre service Citations & Annuaires Locaux prend en charge l'audit + nettoyage + inscription 50+ annuaires + monitoring NAP.
Pilier 8 : Contenu listicle-friendly et chiffré
Bonnes pratiques de contenu LLM-friendly : - Titres H2/H3 explicites en forme de questions - Listes à puces et numérotées - Tableaux comparatifs - Chiffres sourcés (avec source précise) - Citations d'experts identifiés - Sections « TL;DR » ou résumé en tête d'article - FAQ structurée en bas
Pilier 9 : Monitoring multi-LLM mensuel
Sans mesure, pas de pilotage. Routine mensuelle 1h :
- Manuelle - 10 requêtes prioritaires × 6 LLMs (ChatGPT, Perplexity, Gemini, Claude, Copilot, Mistral)
- Outils payants - Profound (sur devis), AthenaHQ (Starter à 295 $/mois, offre Essential gratuite), Otterly.ai (à partir de 29 $/mois), Peec.ai (prix non affichés publiquement), Goodie.ai (à partir de 295 $/mois). Vérifier les prix sur les sites officiels, ils évoluent vite
- Server logs - analyser les hits de GPTBot, ClaudeBot, PerplexityBot, Google-Extended dans vos logs
KPI principal : taux de citation = nombre de requêtes où votre marque est nommée / nombre de requêtes testées (la « part de voix », elle, mesure votre place face aux concurrents cités sur ces mêmes requêtes).
GEO local : les 5 spécificités vs GEO national
Le GEO local diffère du GEO national sur 5 dimensions clés.
1. La distance compte (même pour les LLMs)
Les signaux distance (adresse précise, géocodage exact, schema geo avec lat/lng) sont à soigner.
2. Les avis Google
Google cite le nombre d'avis et les notes parmi les éléments de la proéminence, l'un des trois facteurs de son classement local (aide Google). Voir notre guide complet des avis Google.
3. Les erreurs d'établissement
Un LLM peut se tromper d'établissement si votre NAP est incohérent ou si un concurrent a un nom proche du vôtre. D'où l'importance du Pilier 7.
4. Les annuaires sectoriels
Soignez aussi les annuaires de votre métier : Doctolib, ADO France ou l'Annuaire des Ostéopathes pour un ostéopathe ; Bilik, Travaux.com ou Allovoisins pour un plombier. Pour la liste complète par secteur, voir notre boîte à outils SEO local.
5. Les médias hyperlocaux
Un blog de quartier (« Vivre dans le 4ème », « Bordeaux Métropole Info ») qui parle de vous est une source locale à viser, au même titre que la presse régionale.
Combien de temps pour voir des résultats en GEO local ?
Aucune étude publiée ne donne de délai fiable : il varie selon le moteur, la requête et votre point de départ.
💡 Quick wins GEO local
Pour un cabinet ou commerce local, les 3 actions rapides à mettre en place :
• Wikidata (1h)
• schema.org LocalBusiness rigoureux avec sameAs vers Wikidata (2h)
• Bing Webmaster Tools (30 min)
Pour le reste (Wikipedia, Reddit, presse), penser cycle long.
Les 7 erreurs les plus fréquentes en GEO local 2026
⚠ Les erreurs fatales du GEO local 2026
Erreur 1 : Bloquer GPTBot/ClaudeBot sans raison stratégique : vous vous excluez du corpus d'entraînement. À ne faire que si vous monétisez votre contenu via deals presse. Erreur 2 : Spammer Reddit ou Quora avec des faux comptes : risque de bannissement. Erreur 3 : Acheter une page Wikipedia : risque de suppression. Erreur 4 : Bourrer son contenu de mots-clés IA (« ChatGPT recommande », « selon Gemini ») : anti-pattern flagrant. Erreur 5 : Négliger le NAP cohérent : voir le Pilier 7. Erreur 6 : Schema.org sanssameAs : sans ce champ, votre site n'est pas relié à votre entité Wikidata/Knowledge Panel.
Erreur 7 : Oublier de mesurer ses citations : sans monitoring multi-LLM mensuel, vous travaillez à l'aveugle. Comptez 1h/mois minimum.
Outils GEO local : gratuits et payants
Outils réellement gratuits
À mi-2026, les outils vraiment gratuits pour démarrer le GEO sont peu nombreux. Le marché du monitoring GEO est très majoritairement payant.
- Google Search Console (gratuit) - onglet Performances + logs côté serveur pour mesurer le crawl GoogleOther
- Bing Webmaster Tools (gratuit) - indispensable pour Copilot et ChatGPT (qui browse Bing)
- Wikidata + Wikipedia (gratuit) - création d'entité, demande du temps
- Otterly.ai - propose un essai gratuit (pas un freemium illimité)
- Tracking manuel - interroger soi-même ChatGPT/Perplexity/Gemini/Claude/Copilot/Mistral sur ses 10 requêtes prioritaires une fois par mois (gratuit, 1h de travail)
Outils payants (vérifier les prix en direct, ils évoluent vite)
Prix constatés le 18/10/2026 (toujours vérifier sur les sites officiels) :
- Peec.ai - offres Starter, Pro et Advanced, Enterprise sur devis ; prix non affichés publiquement.
- AthenaHQ - offre Essential gratuite (crédits limités), Starter à 295 $/mois. Enterprise sur devis.
- Otterly.ai - Lite 29 $/mois (15 prompts), Standard 189 $/mois, Premium 489 $/mois.
- Goodie.ai - Core à 295 $/mois, Pro à 999 $/mois. Enterprise sur devis.
- Profound - pricing sur demande (enterprise principalement).
- BrightEdge Generative Parser - enterprise uniquement, sur devis.
- Semrush AI Toolkit - intégré à certains plans Semrush (vérifier la formule actuelle).
Outils Supernova gratuits orientés GEO local
Pour les pros qui veulent gérer leur GEO local en autonomie, notre boîte à outils SEO local regroupe plusieurs générateurs orientés GEO/LLM-friendly : générateur de schema markup, générateur de description GBP structurée, générateur de pages métier-ville, générateur de posts hebdomadaires.
Comment mesurer le ROI du GEO local
Quatre KPIs à suivre mensuellement :
- Taux de citation - nombre de requêtes testées où votre marque est nommée / nombre de requêtes testées. À compléter par la part de voix (votre place face aux concurrents cités) et la fidélité de description (l'IA vous décrit-elle correctement ?) - les composantes de l'« indice de confiance » formalisé par Stéphane Delgado.
- Diversity index - sur combien de LLMs distincts vous êtes cité. Cible : 5+/6 LLMs sur les requêtes prioritaires.
- Trafic référent depuis LLMs - visible dans GA4 (sources : chat.openai.com, perplexity.ai, gemini.google.com).
- Conversions attribuées GEO - UTM dédiés sur les liens présents dans le schema.org et sur les pages susceptibles d'être citées, tracking GA4.
Pour aller plus loin
Le GEO local est le prolongement direct du SEO local, pas une discipline séparée. Maîtriser les fondations SEO d'abord, ajouter les actions GEO-spécifiques ensuite. Pour la fondation SEO, voir notre guide complet du SEO local.
Pour comprendre en profondeur ce qui fait qu'une marque est citée - ou ignorée - par les IA, la méthode Passeport vers la Citation de Stéphane Delgado est la lecture la plus claire en français : quatre phases (cartographier son territoire de requêtes, aligner son entité autour d'une définition canonique, multiplier les points de validation, mesurer son indice de confiance) qui expliquent concrètement pourquoi un contenu seul ne suffit pas si l'entité derrière n'est pas alignée.
Si vous voulez maîtriser le SEO local + GEO en autonomie, notre formation SEO local couvre désormais un module dédié GEO local (schema avancé, Wikidata, Reddit, mesure des citations multi-LLM).
Si vous préférez externaliser, notre offre de gestion de fiche Google active les fondations SEO + GEO local pour vous.
Pour démarrer par un état des lieux et savoir où vous en êtes sur Google et sur les LLMs, demandez votre diagnostic gratuit - on audite votre fiche GBP + votre Share of Voice sur ChatGPT/Perplexity/Gemini sur 5 requêtes de votre choix, on identifie les 3-5 quick wins prioritaires, et on chiffre le potentiel de gain en clients/mois.
Les chiffres à retenir
Croissance trafic Perplexity entre avr. 2024 et mars 2025
Source : OneLittleWeb (données Semrush), avril 2025
Croissance trafic ChatGPT entre avr. 2024 et mars 2025 (47,7 Md visites)
Source : OneLittleWeb (données Semrush), avril 2025
L'auteur
Alexandre
Fondateur de SEO Supernova
Je m'appelle Alexandre, fondateur de SEO Supernova. Je n'ai jamais cru au SEO qui apporte « du trafic ». Ce qui compte, c'est le chiffre d'affaires que mes clients génèrent grâce à leur visibilité Google Maps. C'est mon obsession depuis 6 ans. Pas de hacks, pas de fumée - juste une méthode reproductible et appliquée 90 jours d'affilée.
FAQ
Questions fréquentes
Si je suis cité par un LLM, est-ce que je perds le clic que j'aurais eu sur Google ?
C'est la question légitime du « zero-click ». Réponse nuancée : sur les requêtes très transactionnelles locales (« réserver un restaurant », « prendre RDV chez le kiné »), les utilisateurs cliquent quand même sur votre lien - le LLM ne peut pas réserver à leur place. Sur les requêtes purement informationnelles (« qu'est-ce qu'un détartrage »), le LLM répond directement et le clic peut être perdu. Stratégie : structurer son contenu pour répondre clairement à l'info (le LLM cite votre nom = branding) tout en gardant un appel à l'action concret qui nécessite de cliquer (prise de RDV, devis, formulaire). Tracking conseillé : UTM dédiés sur les liens présents dans votre schema.org et vos pages susceptibles d'être citées.
Que faire si un LLM diffuse une fausse information sur mon entreprise ?
Procédure en 4 étapes :
• Capturer la preuve - screenshot avec URL de la conversation et date
• Corriger la source - identifier d'où vient l'info (souvent un site mal mis à jour, une fiche annuaire obsolète, un avis erroné, une page Wikipedia incorrecte) et corriger la source primaire
• Signaler via les canaux officiels - ChatGPT : bouton 👎 sous la réponse + Help Center OpenAI ; Gemini : feedback intégré ; Perplexity : signalement en bas de réponse
• Si diffamation - droit français applicable, mise en demeure possible via avocat IT
Le cadre juridique des contenus générés par IA reste flou en 2026, jurisprudence en construction.
Un mauvais avis Google peut-il polluer la réponse d'un LLM sur ma marque ?
Oui, et c'est plus risqué qu'en SEO classique. En SEO, un avis 1★ se noie dans une moyenne. Dans une réponse LLM synthétisée, un avis très détaillé et négatif peut être cité comme exemple représentatif, surtout s'il est récent et long. Mitigation : (1) répondre publiquement et factuellement à tous les avis négatifs détaillés (la réponse pondère la perception) ; (2) inciter à la collecte de nouveaux avis positifs après chaque avis négatif pour diluer ; (3) si avis frauduleux : signaler à Google + procédure de suppression. Voir notre guide complet de réponse aux avis négatifs.
Le RGPD impose-t-il quelque chose sur les données utilisées par les LLMs ?
Oui - depuis 2024, la CNIL et le Comité européen de la protection des données (EDPB) ont publié plusieurs avis sur les LLMs, dont l'avis 28/2024 de l'EDPB (décembre 2024). Points clés en France/UE : (1) les LLMs entraînés sur des données personnelles européennes doivent respecter le RGPD (base légale, droit à l'effacement, transparence) ; (2) les particuliers peuvent demander à OpenAI/Anthropic/Google de retirer leurs données personnelles du corpus d'entraînement (procédures formelles disponibles sur les sites des éditeurs) ; (3) pour les entreprises, le RGPD ne joue pas sur la raison sociale (donnée publique). Conséquence GEO local pour une PME : votre raison sociale, adresse, téléphone pro sont libres d'usage par les LLMs ; les données nominatives de vos clients ne doivent jamais transiter dans un prompt ou un chatbot sans base légale (consentement, contrat, intérêt légitime documenté).
Comment savoir quel LLM utilisent prioritairement mes prospects ?
Deux méthodes croisées :
• GA4 - source/medium : filtrer le trafic référent provenant de chat.openai.com, chatgpt.com, perplexity.ai, gemini.google.com, copilot.microsoft.com, chat.mistral.ai. Comparer les volumes mensuels
• Sondage interne : ajouter au formulaire de contact une question « Comment nous avez-vous connus ? » avec ChatGPT / Perplexity / Gemini / Autre LLM en options
Pour une PME française B2C, prioriser l'effort dans cet ordre : ChatGPT, Gemini, Perplexity.
Les agents IA (ChatGPT Operator, Claude Computer Use) vont-ils changer le GEO ?
Oui - c'est probablement le prochain grand virage 2026-2027. Les agents IA naviguent sur le web pour le compte de l'utilisateur (« réserve-moi un dentiste à Lyon 6 pour mardi »). Trois conséquences :
• La qualité UX et le funnel de votre site comptent plus que la simple citation - si l'agent ne sait pas remplir votre formulaire, il choisit un concurrent
• Les schemas Action et Reservation (schema.org/ReserveAction) deviennent critiques pour signaler les actions disponibles
• Les API publiques de prise de RDV (Doctolib, Calendly, OpenTable) seront privilégiées car les agents savent les manipuler
Pour anticiper : auditer son tunnel de conversion en se demandant « est-ce qu'un agent IA peut compléter ce parcours sans humain ? ».